Worker Nodes Workload Map
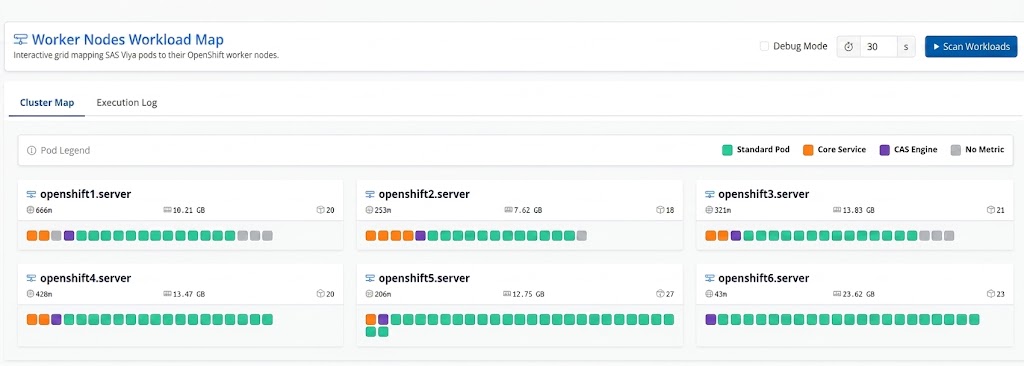
Une carte thermique visuelle du cluster qui corrèle automatiquement tous les pods actifs à leurs nœuds travailleurs OpenShift physiques sous-jacents. Elle calcule et représente graphiquement la consommation globale de CPU et de Mémoire de tous les pods `Running` par rapport à la capacité physique totale de chaque nœud, offrant une vue d'ensemble claire de la saturation du cluster.
Principales fonctionnalités
- Cartes de nœuds interactives : Affiche une carte pour chaque nœud travailleur OpenShift. Chaque carte montre le nom du nœud, l'utilisation totale du CPU par rapport à la capacité totale, l'utilisation totale de la RAM par rapport à la capacité et le nombre total de pods en cours d'exécution assignés à ce nœud.
- Visualisation colorée des pods : Les pods sont représentés comme de petits carrés interactifs à l'intérieur des cartes de leurs nœuds respectifs, classés par catégorie :
- Pod standard (Vert) : Charges de travail d'application générales de SAS Viya.
- Service de base (Orange) : Services backend fondamentaux (par ex., logon, consul, rabbitmq, postgres, opendistro).
- CAS Engine (Violet) : Pods de serveur SAS Cloud Analytic Services.
- Sans métrique (Gris) : Pods qui ne rapportent actuellement pas de données de métriques.
- Infobulles détaillées des pods : Le survol d'un carré de pod révèle une infobulle contenant le nom exact du pod, son étiquette de catégorie et sa consommation de CPU et de RAM en temps réel.
- Filtrage et tri intelligents : Seuls les pods activement dans l'état
Runningsont visualisés. Dans chaque nœud, les pods sont automatiquement triés d'abord par catégorie, puis par consommation de RAM la plus élevée, permettant une identification immédiate des pods gourmands en ressources. - Onglet de journal d'exécution : Fournit les logs d'exécution bruts et les sorties de débogage dans un onglet séparé, aidant les administrateurs à dépanner les exécutions de scripts ou à visualiser les données brutes des métriques.
- Exécution configurable : Propose une bascule "Mode Débogage" et un paramètre de délai d'attente personnalisable (30 secondes par défaut) pour garantir une récupération fiable des métriques, même sur les clusters OpenShift exceptionnellement grands.